模型管理
CubePlex 通过你在组织级别配置的 API 密钥连接 LLM 提供商。设置好提供商并启用其模型后,工作区成员便可在对话中选择这些模型。
所有模型管理操作均在 Admin > Models(/admin/models)中完成。
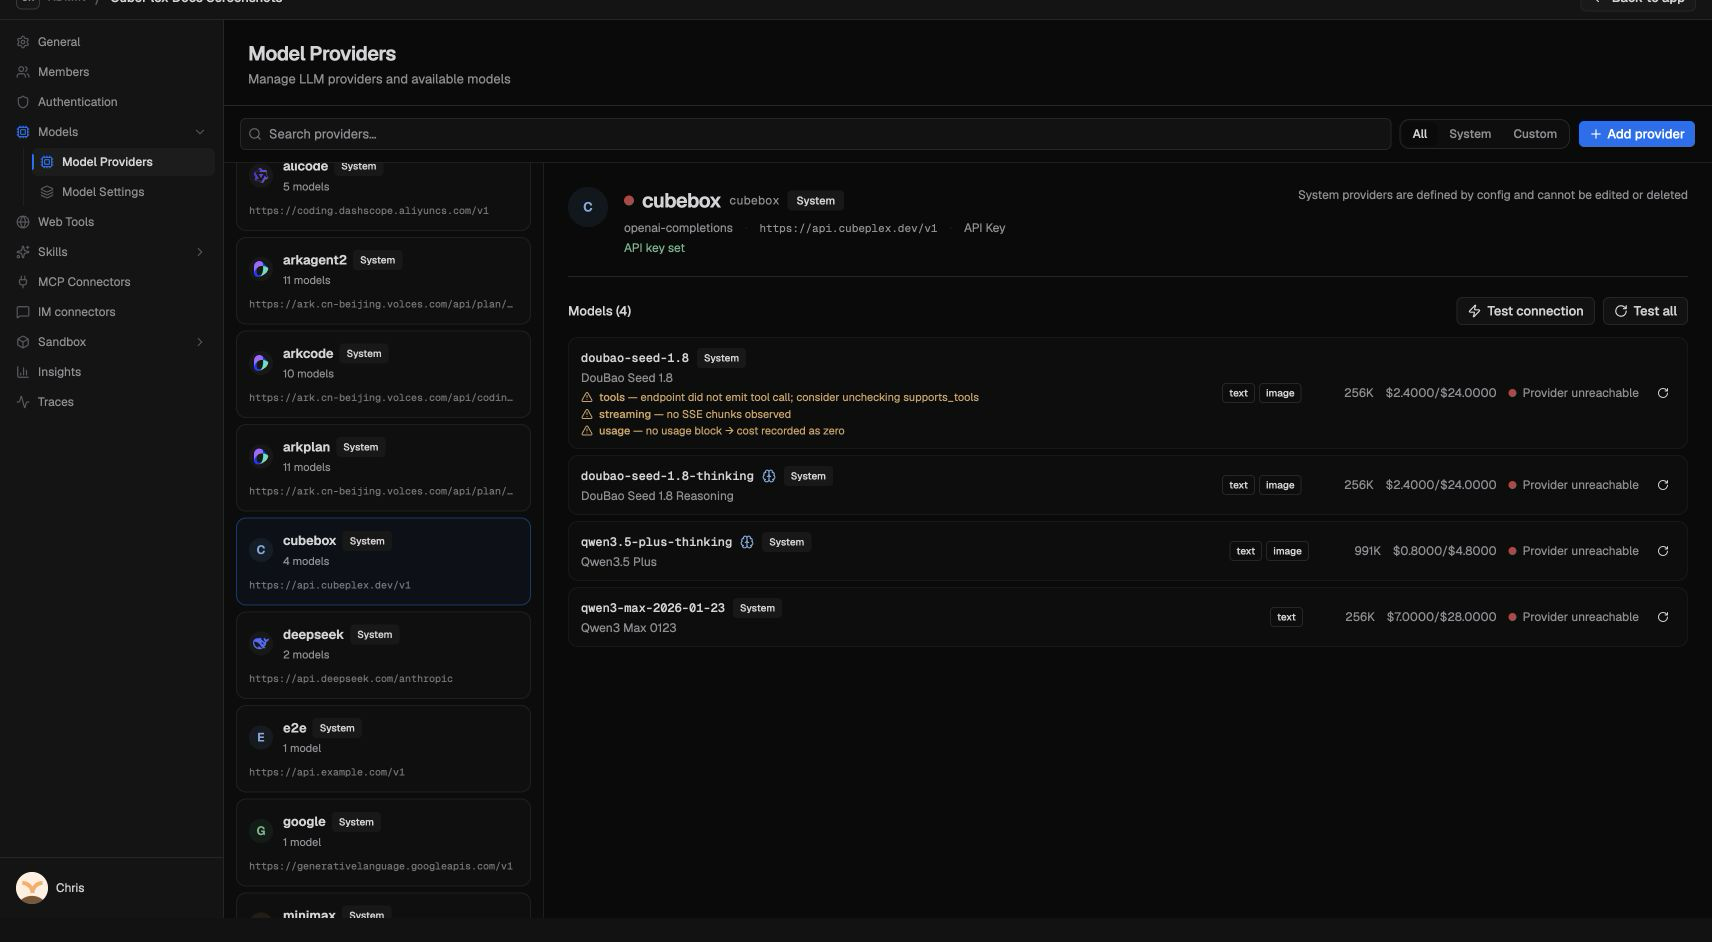
提供商
提供商代表一个 LLM API 端点。每个提供商包含:
- 名称和 slug——供人阅读的标签与 URL 安全标识符。
- Base URL——API 端点(例如 Anthropic 的
https://api.anthropic.com)。 - 认证凭据——通常为 API 密钥。
- 能力描述符——声明提供商支持的能力(聊天、视觉、工具调用等)。
从预设添加提供商
CubePlex 为常见提供商(Anthropic、OpenAI 等)提供预设。预设会预填 Base URL、发现策略与调用配置。填写调用密钥;无密钥的本地端点可选择无认证。
- 前往 Admin > Models。
- 点击 Add Provider。
- 从列表中选择一个预设(例如“Anthropic”)。
- 审核端点与认证方式,点击下一步。
- 点击列出可用模型,审核字段来源、选择模型并导入。
- 运行验证,点击完成启用通过测试的模型。仅提供静态建议的供应商使用手动模型步骤。
添加自定义提供商
任何提供 OpenAI 兼容 chat completions 端点的服务都可以作为自定义提供商添加。
- 前往 Admin > Models。
- 点击 Add Provider。
- 选择 Custom (OpenAI-compatible)。
- 输入名称、Base URL 和 API 密钥。
- 审核调用配置,点击下一步发现模型。
- 补齐缺失字段或解决冲突,导入所选模型,验证后启用。
测试提供商连通性
添加提供商后,点击 Test Connection,验证 CubePlex 是否能够访问端点并完成认证。该测试会发送一个轻量级请求,并报告成功或失败及其详细信息。
模型
每个提供商都会提供一个或多个模型。添加提供商后,可用模型会出现在模型列表中。
单个模型配置
你可以为每个模型配置以下内容:
| 设置 | 说明 |
|---|---|
| 推理能力 | CubePlex 如何将标准推理控制(mode、effort、summary)映射到提供商的传输格式。 |
| 模态 | 输入/输出能力——文本、视觉、工具调用等。 |
| 成本费率 | 每个 token 的成本——输入、输出,以及(如适用)缓存读取 / 缓存写入——用于成本跟踪仪表板。 |
模型如何提供给工作区
配置提供商并启用其模型后,这些模型会出现在组织内每个工作区的模型选择器中。工作区成员可在开始或继续对话时选择模型。
常见任务
轮换 API 密钥
- 前往 Admin > Models 并选择该提供商。
- 使用新密钥更新 API key 字段。
- 点击 Save,然后点击 Test Connection,确认新密钥可用。
禁用模型
如果你不想再向团队提供某个特定模型,请在模型列表中禁用它。使用过该模型的现有对话会被保留,但用户无法为新消息选择该模型。
添加自托管或代理端点
对于相应部署请选择 CLIProxyAPI、vLLM 或 Ollama;其他兼容端点使用自定义提供商。确保 CubePlex 后端服务器能够访问该 Base URL。
为自定义端点配置推理
CubePlex 为每个对话保存一组标准推理控制:
| 字段 | 值 |
|---|---|
mode | off、auto 或 on |
effort | minimal、low、medium、high 或 max |
summary | none、auto、detailed 或 summarized |
官方 OpenAI Chat Completions、OpenAI Responses 和 Anthropic Messages 的提供商预设,已经会将该标准结构转换为各 API 所需的请求载荷。对于自定义或代理端点,请添加一个能力描述符,告诉 CubePlex 应写入哪些字段:
{
  "reasoning": {
    "mode_payloads": {
      "off": { "extra_body": { "thinking": "disabled" } },
      "on": { "extra_body": { "thinking": "enabled" } }
    },
    "effort_path": "reasoning_effort",
    "effort_values": {
      "minimal": "minimal",
      "low": "low",
      "medium": "medium",
      "high": "high",
      "max": "max"
    },
    "apply_effort_when_off": false,
    "unsupported_mode_policy": "skip"
  }
}
对于 Responses 风格的嵌套请求载荷,请使用 effort_path: "reasoning.effort";对于 LiteLLM 等 OpenAI 兼容网关,请将提供商特定字段放在 extra_body 下。如果模型仅支持开启/关闭推理,请省略 effort_path 和 effort_values。
发现并导入模型
先选择供应商。CLIProxyAPI 与 vLLM、Ollama 一样是独立选项。填写 CubePlex 后端能够访问的 base URL 与调用密钥;无密钥的端点选择无认证。下一步会先保存供应商。名称或 slug 已被占用时,错误留在这一步,不会进入模型列表。随后的列出可用模型读取这个已保存的供应商。
各供应商的发现接口不同。OpenAI 兼容实例通常提供 GET /v1/models;Anthropic 使用自己的认证及游标分页;Ollama 使用 /api/tags,并通过 /api/show读取所选模型的详情。没有经过验证的适配器时,界面提供预置建议和手动配置。
审核返回的 ID 与各字段来源。可以全选聊天候选模型,确认已核实的建议,或将已审核的上下文和输出上限应用到所选组。未知字段保持未知。实时列表与目录不一致时,先采用列表里的值;可以改选目录来源,或直接填写另一个值。其他来源冲突仍需要选择来源或明确填写。如果导入时仍提示缺少必需参数,错误信息和模型行会写出这些字段。Embedding、音频和图片生成模型不能作为 agent 聊天模型导入。缺失的价格表示估算未知,不代表免费。
可用搜索模型或仅显示已选模型缩小列表。每行会列出缺少的必需参数;补齐前,导入所选模型按钮保持禁用。点击检查已选模型可展开需要处理的已选项。确认的值与选择的来源会立即更新可导入数量。上下文窗口和输出上限必须为正整数,且输出不能大于上下文。
连接与能力检查每次请求最多等待 30 秒,以容纳代理延迟。等待中的模型会持续显示,失败时展示上游原因或超时信息。只有通过必需检查的模型才能启用。
CLIProxyAPI 的模型列表会与 CubePlex 自带的 models.dev 供应商快照比对。调用 ID 完全一致时,上下文、输出上限、输入模态和推理会作为已声明的值填入。同一个 ID 出现在多个供应商时,采用 Anthropic、OpenAI、Google 或 xAI 的官方记录。只有完整 ID 不存在时,才会去掉一个已知后缀,例如 thinking 或 high;fast 和 preview 会保留。价格只在大于 0 时复制。快照里没有的模型仍会列出,上下文和输出上限留空,这两项可以手填。手改的值会覆盖目录记录。Ollama 可先选择最多 100 个模型并点击加载所选模型详情,再审核参数。
导入所选模型按每批最多 100 个创建禁用状态的模型。已有 ID 保持原配置并跳过,重试也一样。发现预览在 10 分钟后过期;过期或调用配置变化后需要重新发现。同一发现回执可在 24 小时内恢复供应商创建结果;已删除的供应商不能通过重放回执恢复。
运行模型测试后,点击启用已验证模型,或在向导完成时启用通过测试的模型。测试检查真实流式输出和完整工具调用,并检查已声明的推理、图片输入能力。必需能力失败时,模型保持禁用。模型设置只列出已启用的模型。
修改端点、密钥、上限或调用能力后,旧证据显示待验证。已启用模型仍可使用;禁用的导入模型需要当前配置通过测试才能首次启用或再次启用。已经绑定的调用保留其快照;新调用、延迟开始及恢复执行时绑定当前配置。
升级时应用迁移,并执行一次旧数据来源补录:
cd backend
uv run alembic upgrade head
uv run python scripts/dev/backfill_model_discovery.py
补录可重复执行,保留启用状态,把旧测试标记为历史证据,不会将历史测试提升为当前通过结果。旧的零价格在确认前保持未知。
在编辑 → 高级选项中可单独审核各模型的调用配置。导入的模型保留自己的能力覆盖;使用供应商配置会删除该覆盖。表单仅提交已修改字段及显示时的版本号,并发修改后需要重新加载。新声明的图片能力通过视觉测试后才开放图片附件,已启用的手动模型也遵循这个规则;文本调用仍可使用。推理验证使用小输出预算,只在容纳明确映射的思考预算时提高,并始终受已保存的输出上限约束。
当前配置的推理测试失败时,选择器与接收消息的检查会限制相应的显式推理控制。模型默认及已启用的文本调用仍可使用。旧配置的失败既不能证明新配置可用,也不会限制新配置中已审核的映射。